
基于注意力机制的物理信息神经网络求解非定常 Navier–Stokes 方程
中文论文:Navier–Stokes 方程组、矩阵、分段函数、带下括号注释的损失函数、定理框、子图、三线表和 GB/T 7714 参考文献。
下载源文件并解压,把文件夹拖进转换器即可得到同样的结果;改写其中的文字,就是你自己的文档。
打开转换器---
title: 基于注意力机制的物理信息神经网络求解非定常 Navier–Stokes 方程
author: 王明^1^ 李华^1,2^ 陈思远^2^
date: 2026 年 9 月
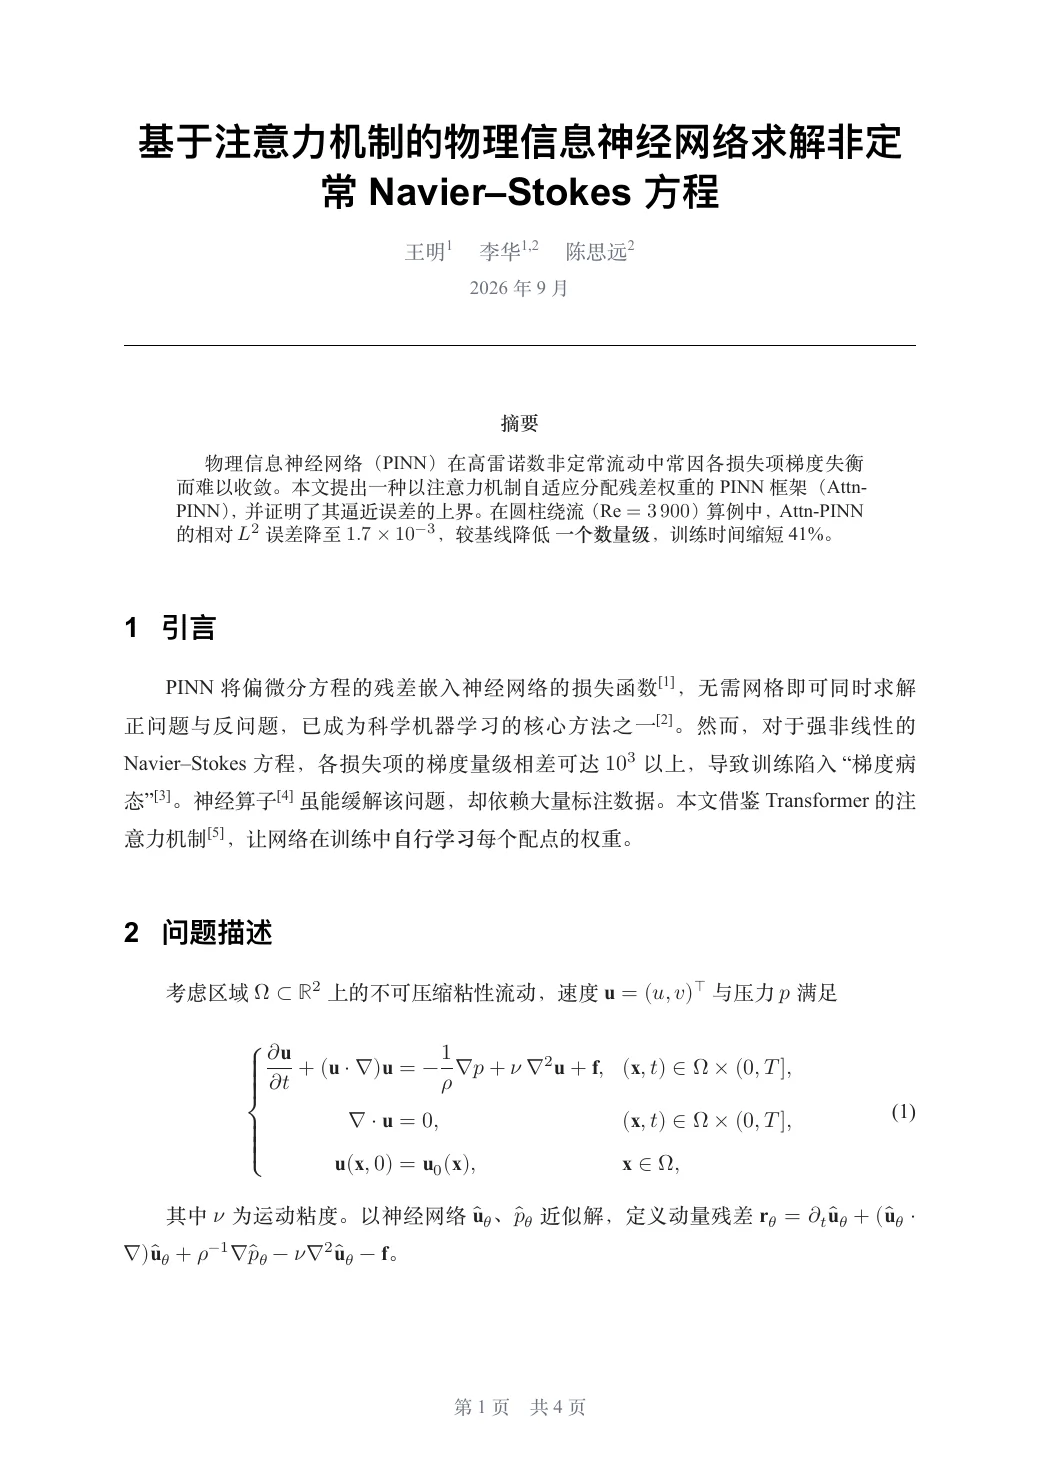
abstract: 物理信息神经网络(PINN)在高雷诺数非定常流动中常因各损失项梯度失衡而难以收敛。本文提出一种以注意力机制自适应分配残差权重的 PINN 框架(Attn-PINN),并证明了其逼近误差的上界。在圆柱绕流($\mathrm{Re}=3\,900$)算例中,Attn-PINN 的相对 $L^2$ 误差降至 $1.7\times10^{-3}$,较基线降低 **一个数量级**,训练时间缩短 41%。
bibliography: refs.bib
number-sections: true
---
# 引言
PINN 将偏微分方程的残差嵌入神经网络的损失函数[@raissi2019],无需网格即可同时求解正问题与反问题,已成为科学机器学习的核心方法之一[@karniadakis2021]。然而,对于强非线性的 Navier–Stokes 方程,各损失项的梯度量级相差可达 $10^{3}$ 以上,导致训练陷入“梯度病态”[@wang2021]。神经算子[@li2021]虽能缓解该问题,却依赖大量标注数据。本文借鉴 Transformer 的注意力机制[@vaswani2017],让网络在训练中**自行学习**每个配点的权重。
# 问题描述 {#sec:problem}
考虑区域 $\Omega\subset\mathbb{R}^2$ 上的不可压缩粘性流动,速度 $\mathbf{u}=(u,v)^{\top}$ 与压力 $p$ 满足
$$
\left\{
\begin{aligned}
\frac{\partial \mathbf{u}}{\partial t} + (\mathbf{u}\cdot\nabla)\mathbf{u}
&= -\frac{1}{\rho}\nabla p + \nu\,\nabla^{2}\mathbf{u} + \mathbf{f},
&& (\mathbf{x},t)\in\Omega\times(0,T],\\
\nabla\cdot\mathbf{u} &= 0,
&& (\mathbf{x},t)\in\Omega\times(0,T],\\
\mathbf{u}(\mathbf{x},0) &= \mathbf{u}_0(\mathbf{x}),
&& \mathbf{x}\in\Omega,
\end{aligned}
\right.
$$ {#eq:ns}
其中 $\nu$ 为运动粘度。以神经网络 $\hat{\mathbf{u}}_{\theta}$、$\hat{p}_{\theta}$ 近似解,定义动量残差
$\mathbf{r}_{\theta} = \partial_t\hat{\mathbf{u}}_{\theta} + (\hat{\mathbf{u}}_{\theta}\cdot\nabla)\hat{\mathbf{u}}_{\theta} + \rho^{-1}\nabla\hat{p}_{\theta} - \nu\nabla^{2}\hat{\mathbf{u}}_{\theta} - \mathbf{f}$。
# 方法 {#sec:method}
## 注意力加权残差
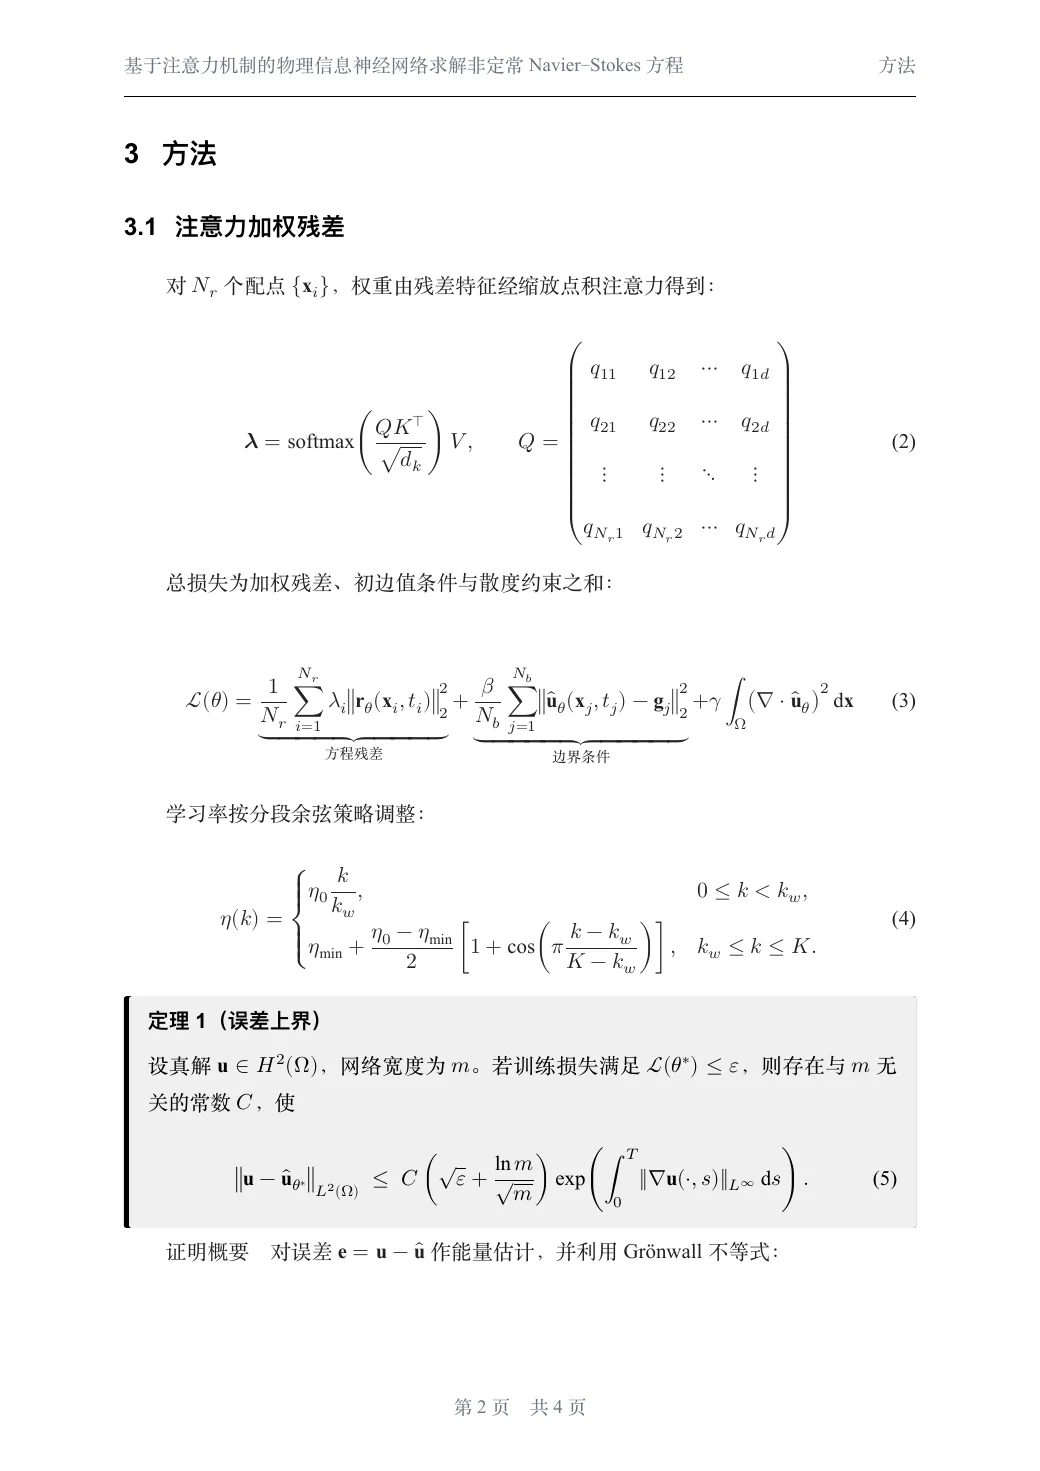
对 $N_r$ 个配点 $\{\mathbf{x}_i\}$,权重由残差特征经缩放点积注意力得到:
$$
\boldsymbol{\lambda} = \operatorname{softmax}\!\left(\frac{Q K^{\top}}{\sqrt{d_k}}\right)V,
\qquad
Q = \begin{pmatrix}
q_{11} & q_{12} & \cdots & q_{1d}\\
q_{21} & q_{22} & \cdots & q_{2d}\\
\vdots & \vdots & \ddots & \vdots\\
q_{N_r 1} & q_{N_r 2} & \cdots & q_{N_r d}
\end{pmatrix}
$$ {#eq:attn}
总损失为加权残差、初边值条件与散度约束之和:
$$
\mathcal{L}(\theta)
= \underbrace{\frac{1}{N_r}\sum_{i=1}^{N_r} \lambda_i \bigl\lVert \mathbf{r}_{\theta}(\mathbf{x}_i,t_i) \bigr\rVert_2^{2}}_{\text{方程残差}}
+ \underbrace{\frac{\beta}{N_b}\sum_{j=1}^{N_b} \bigl\lVert \hat{\mathbf{u}}_{\theta}(\mathbf{x}_j,t_j)-\mathbf{g}_j \bigr\rVert_2^{2}}_{\text{边界条件}}
+ \gamma \int_{\Omega} \bigl(\nabla\cdot\hat{\mathbf{u}}_{\theta}\bigr)^{2}\,\mathrm{d}\mathbf{x}
$$ {#eq:loss}
学习率按分段余弦策略调整:
$$
\eta(k) =
\begin{cases}
\eta_0 \dfrac{k}{k_w}, & 0 \le k < k_w,\\[6pt]
\eta_{\min} + \dfrac{\eta_0-\eta_{\min}}{2}\left[1+\cos\!\left(\pi\dfrac{k-k_w}{K-k_w}\right)\right], & k_w \le k \le K.
\end{cases}
$$ {#eq:lr}
::: {.important title="定理 1(误差上界)"}
设真解 $\mathbf{u}\in H^{2}(\Omega)$,网络宽度为 $m$。若训练损失满足 $\mathcal{L}(\theta^{*})\le\varepsilon$,则存在与 $m$ 无关的常数 $C$,使
$$
\bigl\lVert \mathbf{u}-\hat{\mathbf{u}}_{\theta^{*}} \bigr\rVert_{L^{2}(\Omega)}
\;\le\; C\left(\sqrt{\varepsilon} + \frac{\ln m}{\sqrt{m}}\right)
\exp\!\left(\int_{0}^{T}\lVert\nabla\mathbf{u}(\cdot,s)\rVert_{L^{\infty}}\,\mathrm{d}s\right).
$$ {#eq:bound}
:::
*证明概要* 对误差 $\mathbf{e}=\mathbf{u}-\hat{\mathbf{u}}$ 作能量估计,并利用 Grönwall 不等式:
$$
\begin{aligned}
\frac{1}{2}\frac{\mathrm{d}}{\mathrm{d}t}\lVert\mathbf{e}\rVert^{2} + \nu\lVert\nabla\mathbf{e}\rVert^{2}
&\le \lVert\nabla\mathbf{u}\rVert_{L^\infty}\lVert\mathbf{e}\rVert^{2} + \lVert\mathbf{r}\rVert\,\lVert\mathbf{e}\rVert \\
&\le \Bigl(\lVert\nabla\mathbf{u}\rVert_{L^\infty} + \tfrac{1}{2}\Bigr)\lVert\mathbf{e}\rVert^{2} + \tfrac{1}{2}\lVert\mathbf{r}\rVert^{2}.
\end{aligned}
$$
积分并代入 [@eq:loss] 即得 [@eq:bound]。$\blacksquare$
# 数值实验 {#sec:exp}
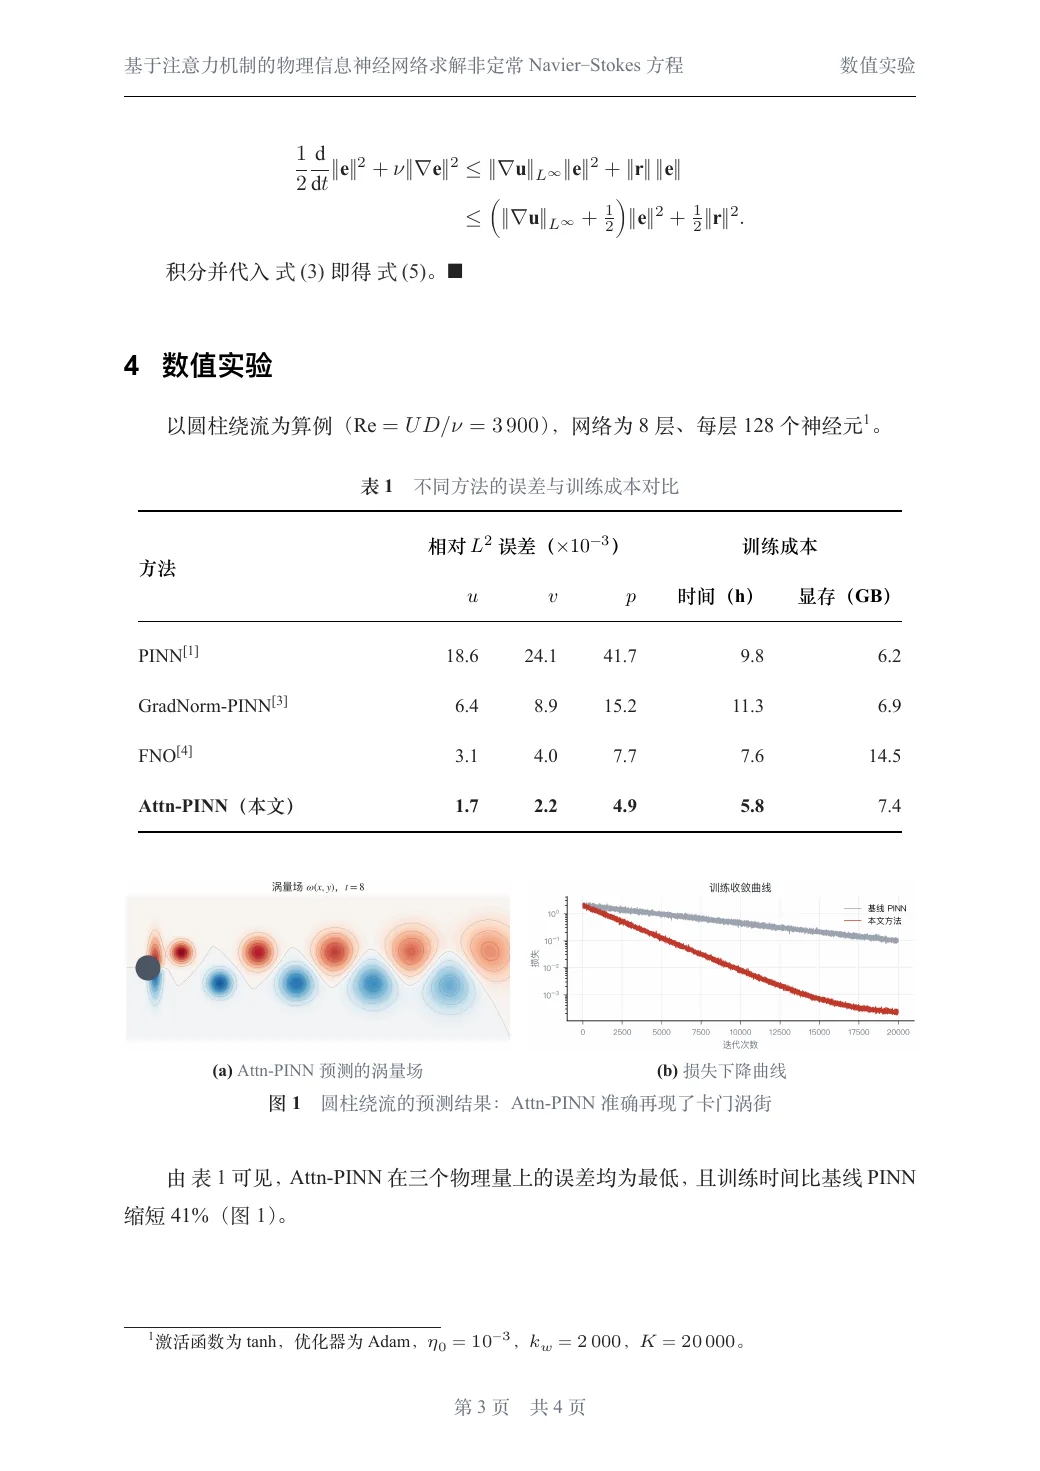
以圆柱绕流为算例($\mathrm{Re}=U D/\nu=3\,900$),网络为 8 层、每层 128 个神经元[^1]。
<table>
<caption>不同方法的误差与训练成本对比 {#tbl:cmp}</caption>
<tr><th rowspan="2">方法</th><th colspan="3" align="center">相对 $L^2$ 误差($\times10^{-3}$)</th><th colspan="2" align="center">训练成本</th></tr>
<tr><th>$u$</th><th>$v$</th><th>$p$</th><th>时间(h)</th><th>显存(GB)</th></tr>
<tr><td>PINN [@raissi2019]</td><td align="right">18.6</td><td align="right">24.1</td><td align="right">41.7</td><td align="right">9.8</td><td align="right">6.2</td></tr>
<tr><td>GradNorm-PINN [@wang2021]</td><td align="right">6.4</td><td align="right">8.9</td><td align="right">15.2</td><td align="right">11.3</td><td align="right">6.9</td></tr>
<tr><td>FNO [@li2021]</td><td align="right">3.1</td><td align="right">4.0</td><td align="right">7.7</td><td align="right">7.6</td><td align="right">14.5</td></tr>
<tr><td><b>Attn-PINN(本文)</b></td><td align="right"><b>1.7</b></td><td align="right"><b>2.2</b></td><td align="right"><b>4.9</b></td><td align="right"><b>5.8</b></td><td align="right">7.4</td></tr>
</table>
::: {#fig:result .subfigures}
{width=49%} {width=49%}
圆柱绕流的预测结果:Attn-PINN 准确再现了卡门涡街
:::
由 [@tbl:cmp] 可见,Attn-PINN 在三个物理量上的误差均为最低,且训练时间比基线 PINN 缩短 41%([@fig:result])。
# 结论
本文提出的 Attn-PINN 以注意力机制自适应平衡残差权重,在理论上给出误差上界([@eq:bound]),在高雷诺数算例中显著优于现有方法。
[^1]: 激活函数为 $\tanh$,优化器为 Adam,$\eta_0=10^{-3}$,$k_w=2\,000$,$K=20\,000$。
# 参考文献← 全部样例 · 样例中的人名、单位和数据均为虚构。